Repositorio GitHub
CódigoCodigo fuente, estructura del proyecto y documentacion tecnica disponible en GitHub.

Dossier de machine learning competitivo
Modelo de machine learning para predecir el equipo ganador en partidas de League of Legends usando datos reales.
Proyecto de Data Science con foco en limpieza de datos, feature engineering, prevencion de data leakage, entrenamiento de modelos y analisis de resultados. La pagina esta lista para incorporar notebook, dataset documentado, metricas, graficas y conclusiones.
League of Legends genera mucha informacion estrategica por partida: objetivos, momentos clave, composicion de equipos y estadisticas. El proyecto aprovecha esa estructura para predecir el equipo ganador.
El objetivo fue construir un modelo capaz de estimar que equipo ganara una partida usando informacion estrategica disponible antes de que la partida este decidida, ademas de entender cuando falla el modelo y por que.
La presentacion documenta una particion train/test 80/20, comparacion de modelos de clasificacion y seleccion de XGBoost como modelo final.
La optimizacion usa Randomized Search con validacion cruzada CV = 3 y ROC-AUC como criterio principal.
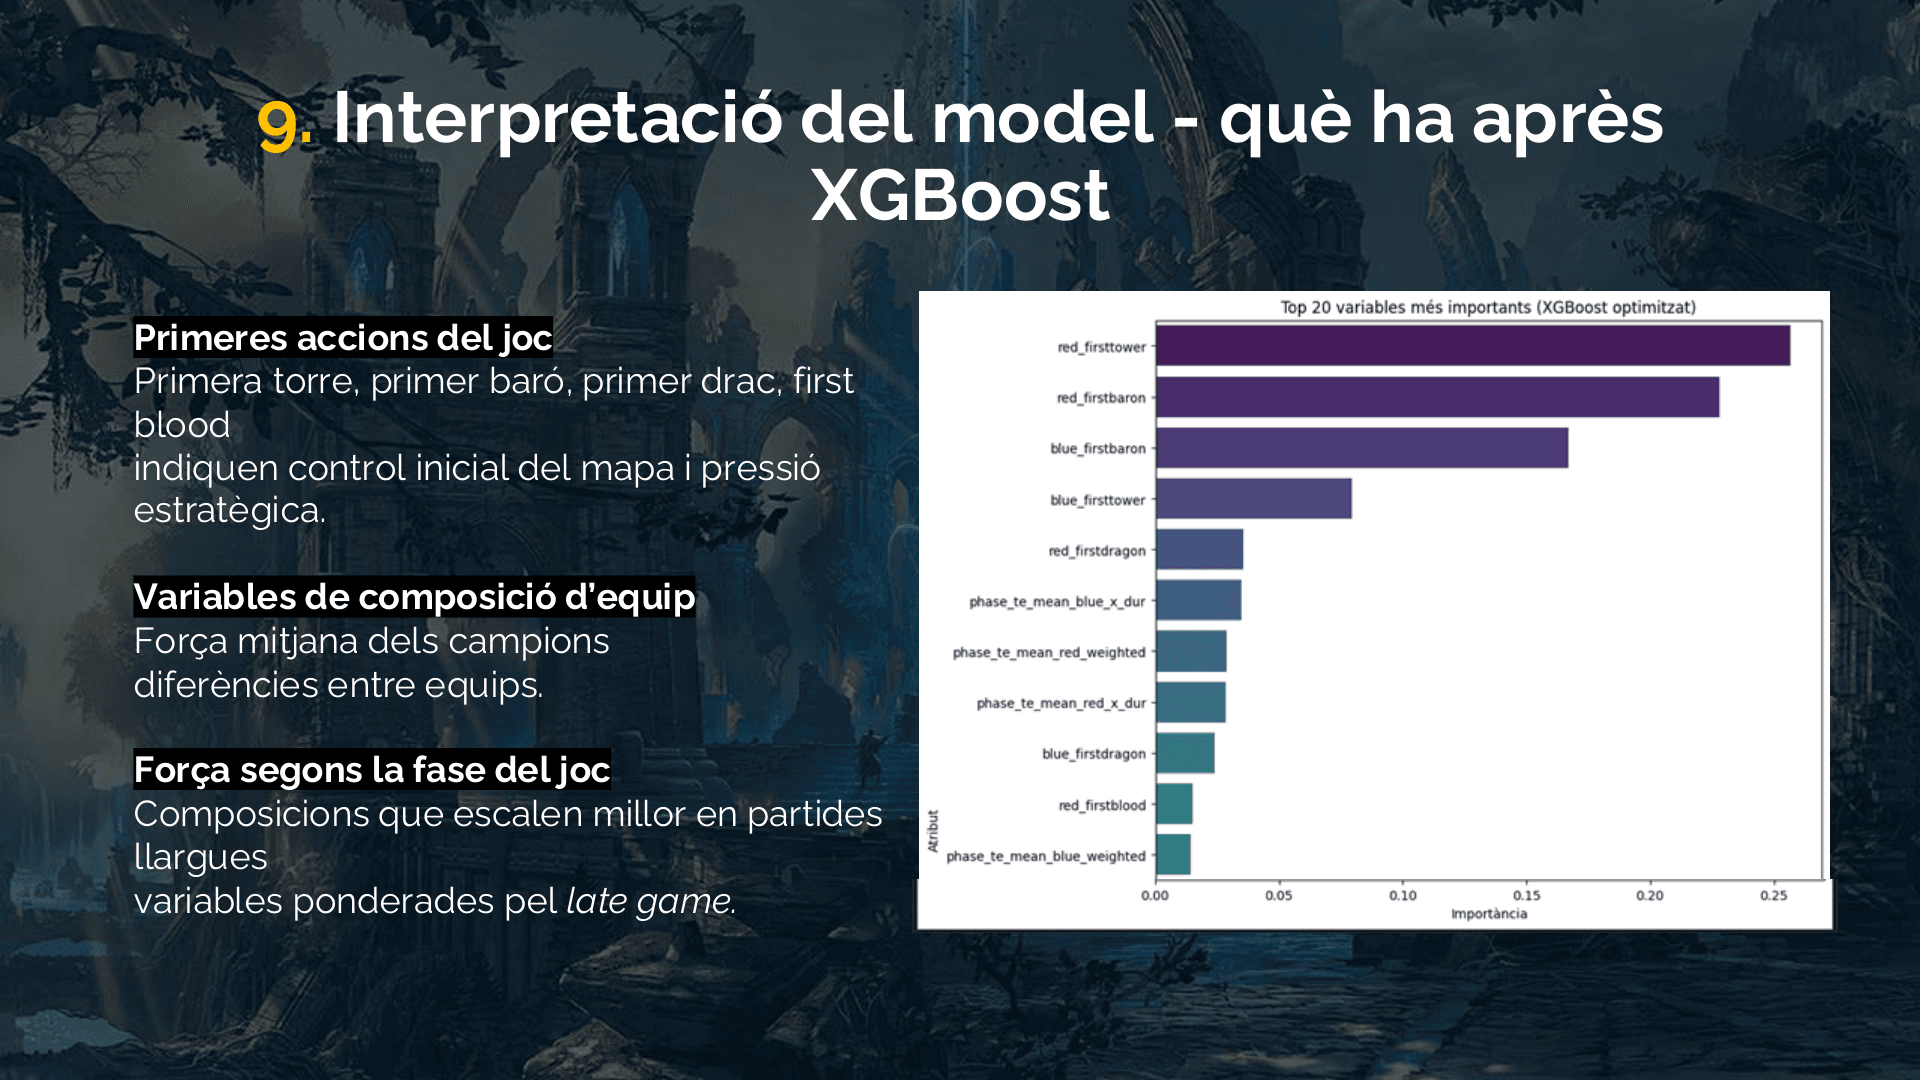
El proyecto concluye que XGBoost ofrece el mejor equilibrio entre rendimiento y generalizacion. Las variables creadas de composicion, fases y late game aportan valor real al enfoque estrategico y explicable.
Documentación, notebooks, entregables y archivos organizados como dossier consultable.
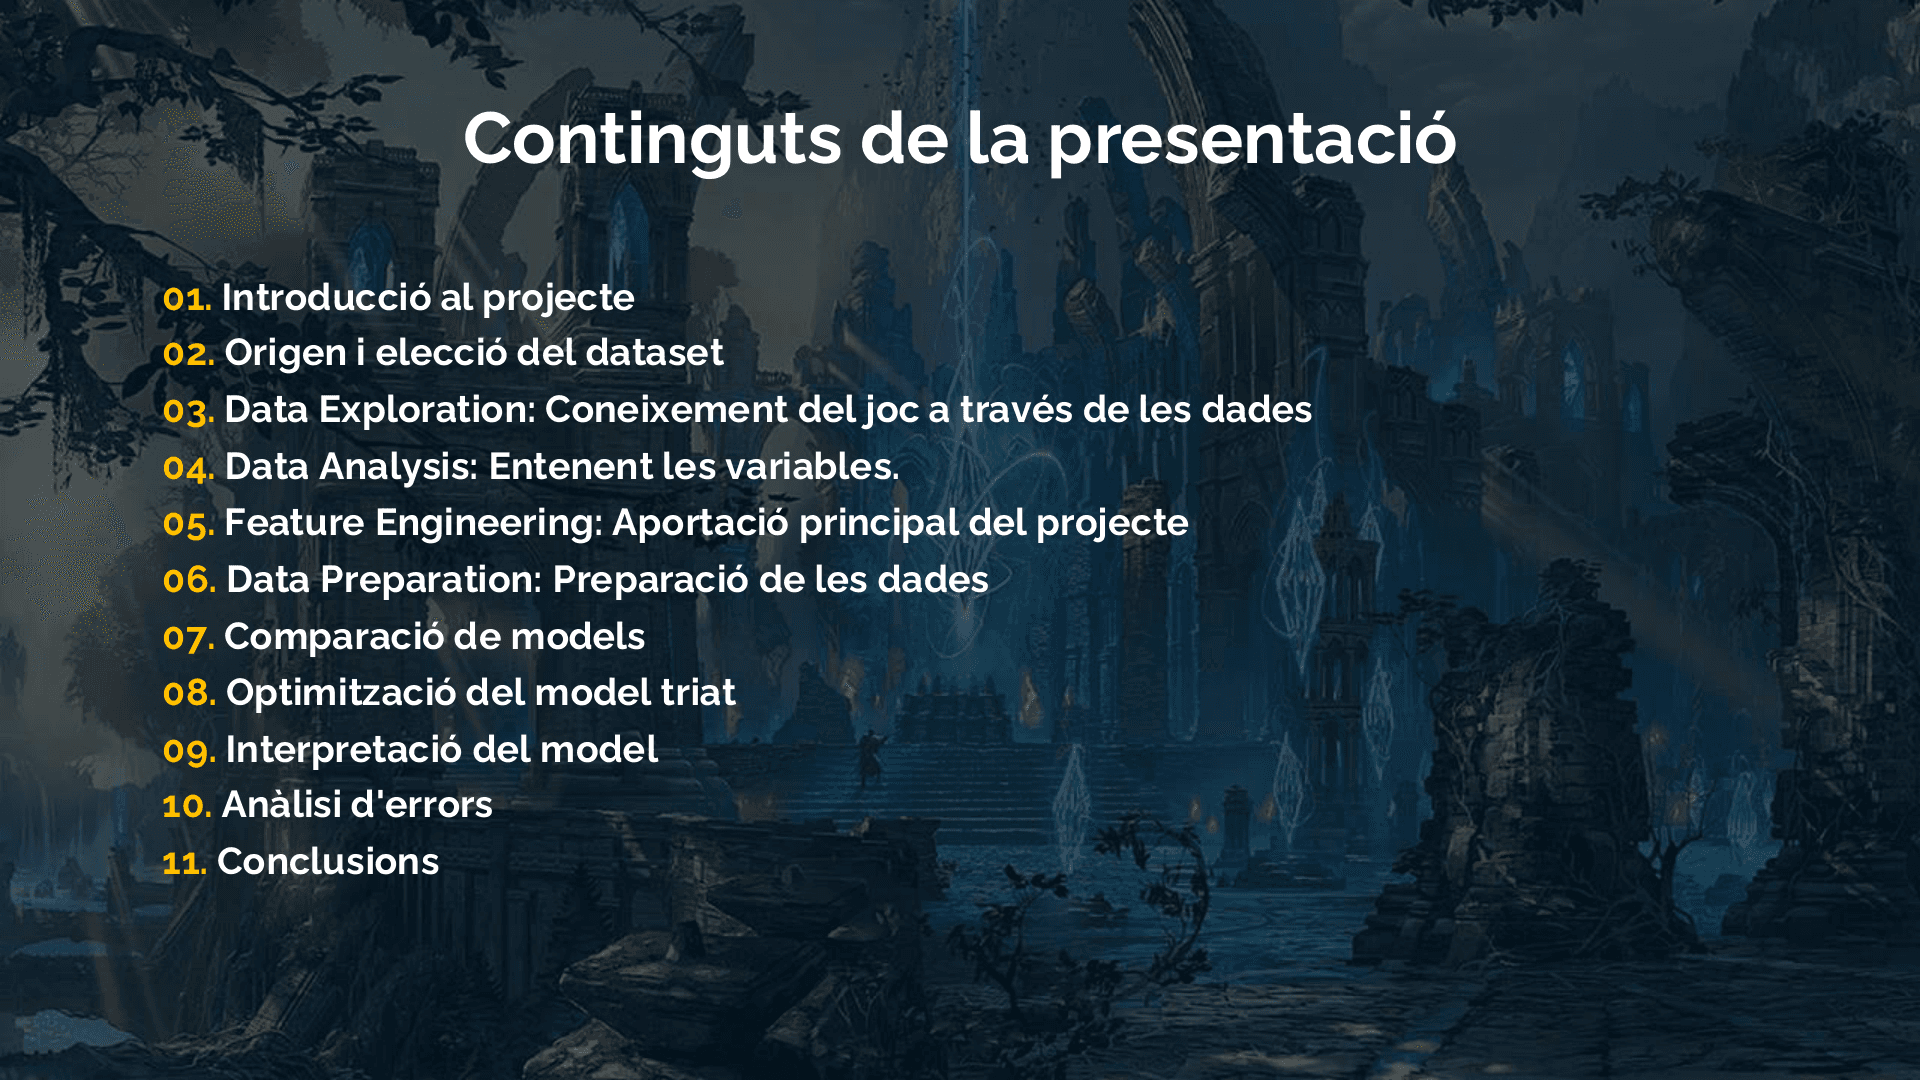
La presentacion organiza el proyecto desde exploracion y feature engineering hasta comparacion, optimizacion e interpretacion.
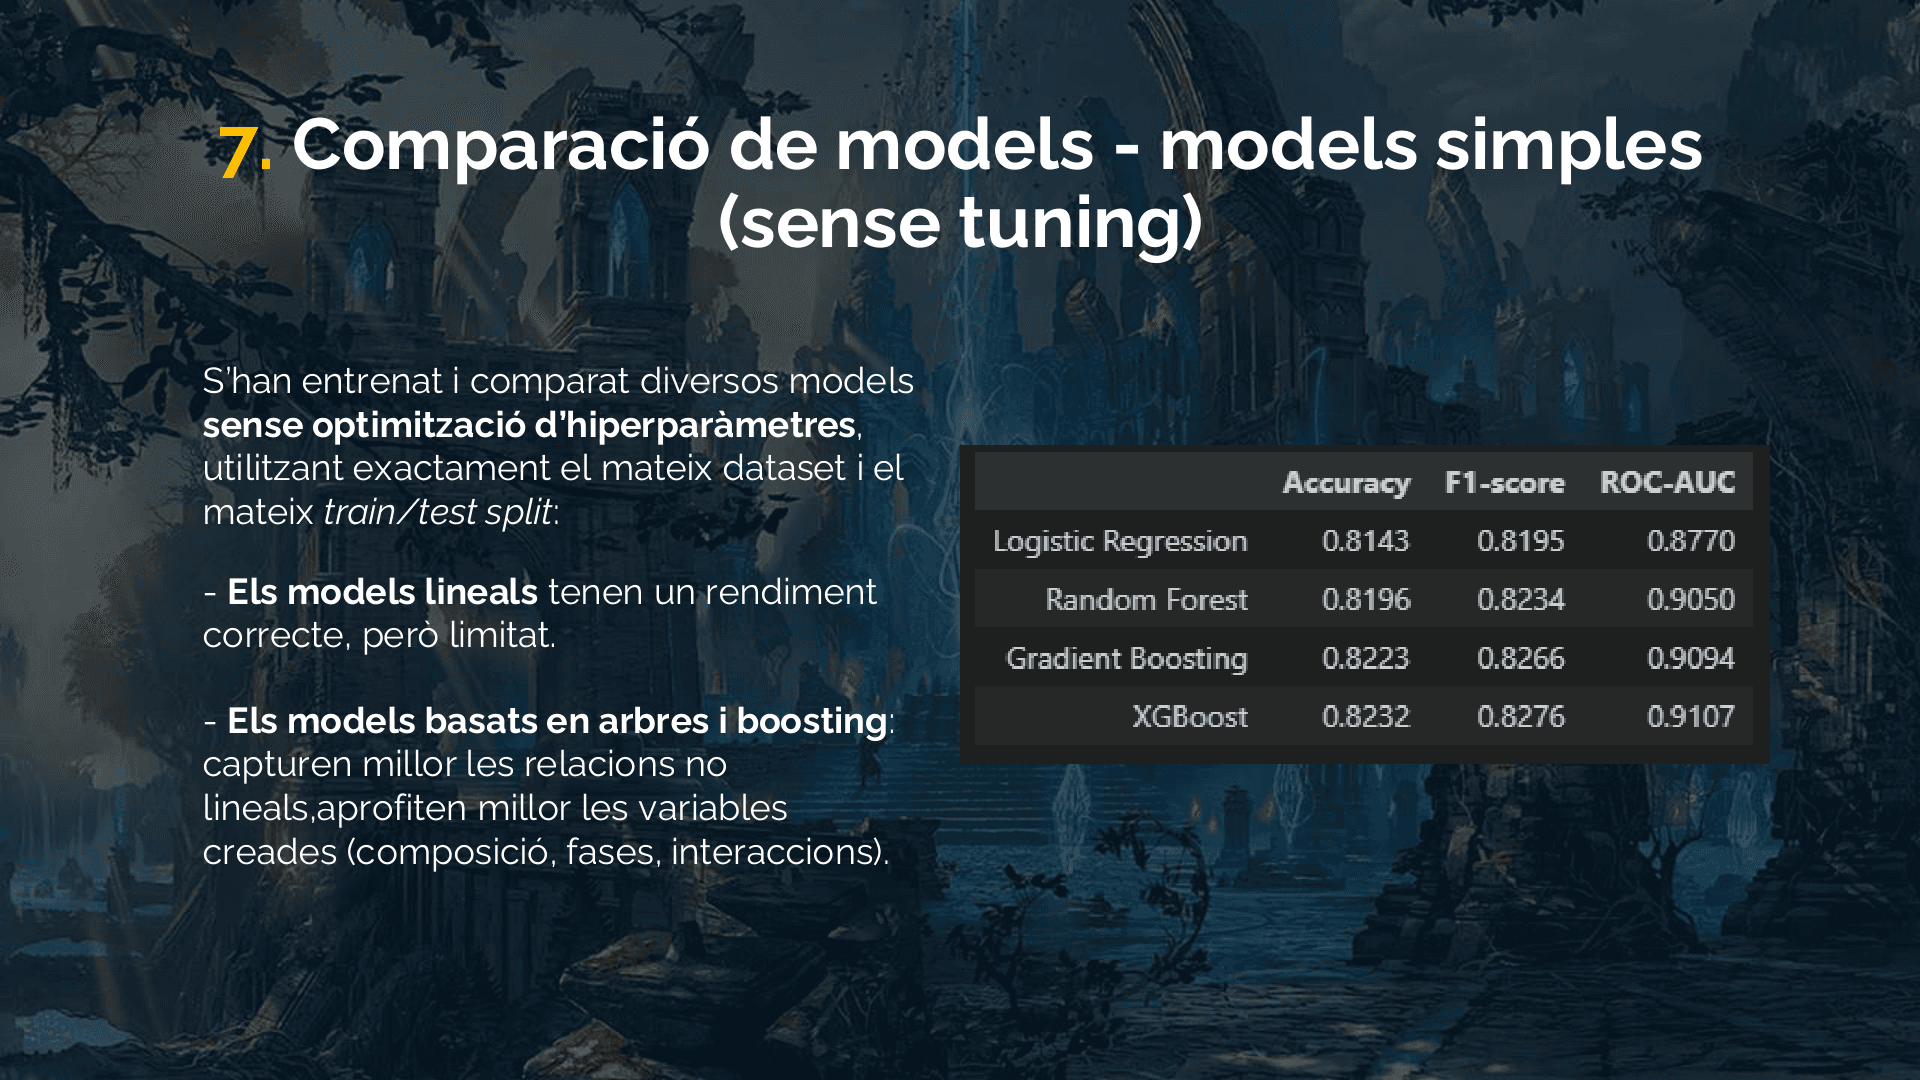
Validacion train/test 80/20 y comparacion de modelos de clasificacion.
Seccion dedicada a entender en que casos falla el modelo.
La pagina no muestra metricas numericas finales porque la extraccion textual de la presentacion no proporciona esos valores de forma verificable.
La informacion ampliada procede de la presentacion PDF incluida como recurso.