Repositorio GitHub
CódigoCódigo fuente y notebooks del proyecto.
Predicción de cancelaciones con validación temporal, selección de umbral y SHAP
Proyecto finalizado del Máster en Data Science & IA: clasificación de reservas hoteleras con Python y scikit-learn, centrada en el equilibrio entre detección de cancelaciones y falsas alarmas.
119.390 reservas, dos hoteles y una evaluación temporal. El trabajo combina auditoría de datos, prevención de leakage, EDA, pipelines, comparación y optimización de modelos, selección de HistGradientBoosting con umbral 0,30 e interpretación SHAP. En TEST alcanza ROC-AUC 0,8914 y Recall 89,0 %, con Precision 68,2 % y 52,9 % de reservas señaladas.
Proyecto del Máster en Data Science & IA de Evolve Academy. La clasificación binaria estima el riesgo de cancelación: is_canceled = 1 significa cancelada y 0, no cancelada. El objetivo es aproximar una predicción en el momento de reservar, pendiente de validar la disponibilidad temporal real de las variables.
Una cancelación no detectada puede dejar una habitación vacía; una falsa alarma puede generar contactos innecesarios. La selección equilibra discriminación, Precision, Recall, F1 y volumen de reservas señaladas, no solo una métrica.
El desbalanceo es moderado. Accuracy no se utiliza como métrica principal. Se conserva un ADR extremo de 5.400 €, 715 reservas sin noches y 180 sin huéspedes registrados al no poder confirmar que sean errores; un ADR negativo pasa a nulo.
Reservas
119.390
City Hotel y Resort Hotel.
Variables originales
32
22 predictores tras la preparación.
Llegadas
2015-2017
Julio de 2015 a agosto de 2017.
Canceladas
37,0 %
44.224 reservas; 75.166 no canceladas.
Filas idénticas adicionales
31.994
Conservadas: no existe un identificador único para confirmar duplicados erróneos.
País ausente
488
Conteo del CSV y notebook; corrige la errata de la presentación.
La fuga de información aparece cuando se usan datos que no estarían disponibles al predecir. Se excluyen el estado final, su fecha y variables potencialmente posteriores a la reserva.
Se conservan lead_time, fechas previstas, hotel, país, canal, segmento, agencia, empresa, cliente, comidas, habitación reservada e historial anterior. ADR, parking y peticiones especiales se mantienen como aproximaciones, no como disponibilidad temporal demostrada.
El código calcula el EDA con las 97.192 reservas anteriores al 1 de mayo de 2017: desarrollo completo, incluyendo la futura validación, pero excluyendo TEST. Los gráficos originales lo rotulan TRAIN; no debe confundirse con las 77.698 reservas de ajuste.
City Hotel presenta un 41,5 % de cancelaciones frente al 26,0 % de Resort Hotel. El segmento Groups alcanza el 60,2 %; el canal TA/TO, 40,3 %, frente al 16,8 % del canal Direct. Son asociaciones descriptivas, no efectos causales.
Solo se ocultan en los gráficos categorías con menos de 100 reservas; sus registros siguen en el dataset.
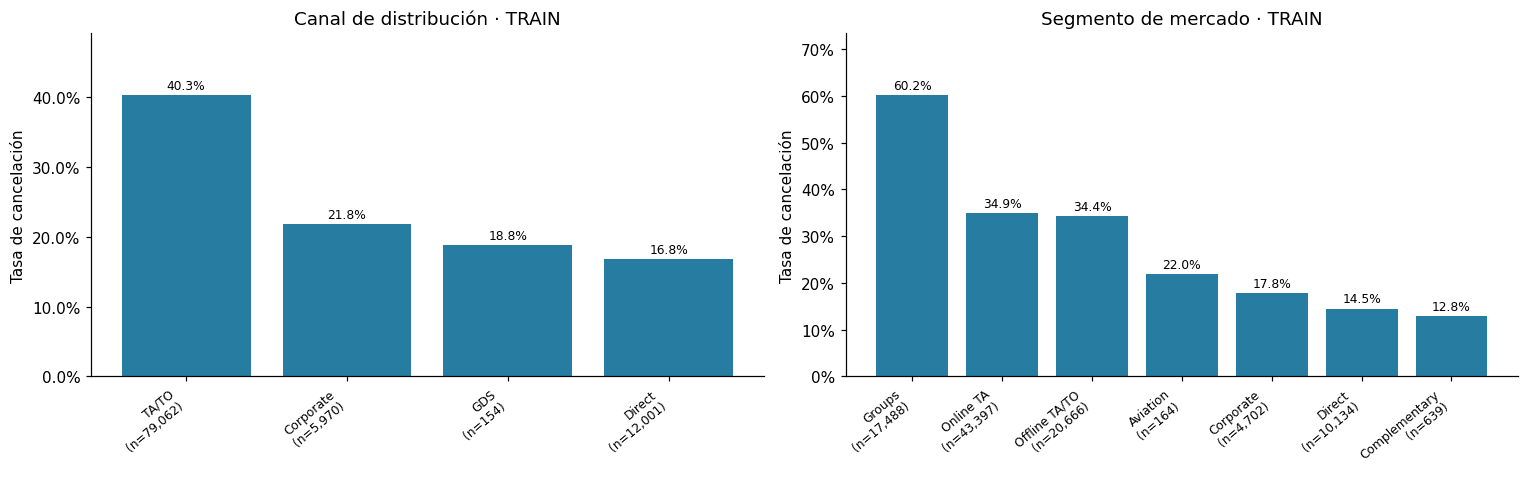
Salida original del notebook, celda 18. Periodo de desarrollo anterior a TEST.
Una mayor antelación se asocia con más cancelaciones en estos datos. El ADR medio es 92,64 € en no canceladas y 96,08 € en canceladas: esta diferencia tampoco demuestra causalidad.
Antelación 0-7 días
9,4 %
Tasa de cancelación.
Más de 180 días
60,0 %
Tasa de cancelación.
Abril / enero
40,8 / 30,5 %
Los meses no incluyen exactamente los mismos años.
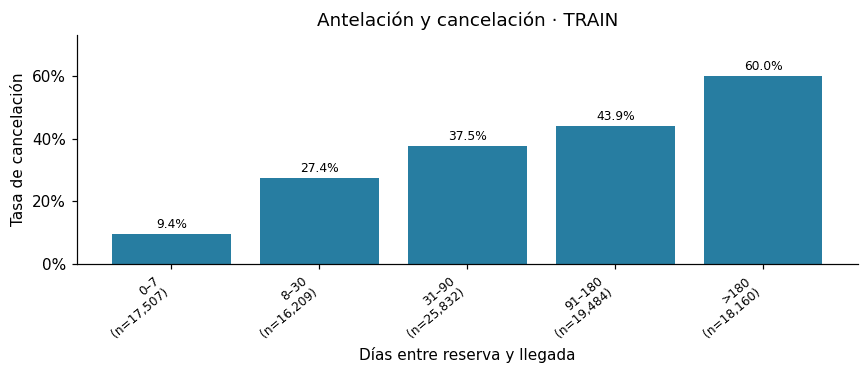
Salida original del notebook, celda 21. No se utiliza TEST para este análisis.
TRAIN ajusta modelos. La búsqueda de hiperparámetros utiliza tres ventanas temporales dentro de TRAIN/FIT, manteniendo juntas las reservas del mismo día. VALIDATION compara configuraciones y selecciona modelo y umbral. TEST se consulta después de fijar la decisión en esta ejecución.
Finalmente se reentrena el pipeline elegido con las 97.192 reservas de desarrollo. El corte es por llegada, no por creación: no reproduce exactamente qué información se conocía al reservar. TEST ya fue evaluado en versiones anteriores, por lo que hace falta otro periodo para una comprobación externa sin exposición previa.
TRAIN / ajuste
77.698
65,08 %. Llegadas: 01/07/2015 a 25/12/2016.
VALIDATION
19.494
16,33 %. Llegadas: 26/12/2016 a 30/04/2017.
TEST
22.198
18,59 %. Llegadas: 01/05/2017 a 31/08/2017.
Las variables numéricas se imputan con mediana y se estandarizan. Las categóricas reciben una categoría desconocida y OneHotEncoder, con handle_unknown=infrequent_if_exist, min_frequency=30 y max_categories=20.
Pipeline encapsula preparación y modelo. Durante la comparación, medianas, escalas y categorías se aprenden solo con el entrenamiento de cada ajuste; en el reentrenamiento final se usa desarrollo completo, nunca TEST.
Logistic Regression es el baseline interpretable; su versión balanced aumenta el peso de la clase cancelada. Random Forest y HistGradientBoosting son los finalistas.
Logistic Regression
0,871
ROC-AUC. Precision 72,3 %; Recall 73,2 %; F1 72,7 %.
Logistic balanced
0,872
ROC-AUC. Precision 65,4 %; Recall 83,3 %; F1 73,2 %.
Random Forest
0,895
ROC-AUC. Precision 83,2 %; Recall 57,1 %; F1 67,7 %.
HistGradientBoosting
0,902
ROC-AUC. Precision 81,0 %; Recall 62,1 %; F1 70,3 %.
RandomizedSearchCV prueba 12 combinaciones de Random Forest: árboles, profundidad, mínimo de división, mínimo por hoja, variables por división y peso de clases. GridSearchCV prueba cuatro combinaciones de HGB: hojas (15/31) y regularización L2 (0,1/5,0). En HGB se mantienen learning_rate=0,08 y max_iter=150; no se optimiza la tasa de aprendizaje.
Ambas búsquedas optimizan ROC-AUC medio en tres ventanas temporales de TRAIN/FIT. En VALIDATION el AUC de RF pasa de 0,8950 a 0,8933 y el de HGB de 0,9018 a 0,8998. Se comparan las versiones antes de decidir, sin dar por ganadora la etiqueta optimized.
HGB inicial ofrece mejor AUC, Precision y F1 que RF optimizado con menos intervenciones, a costa de 2,5 puntos de Recall. La versión optimizada de HGB no aporta una mejora operativa suficiente.
Configuración final: max_iter=150, learning_rate=0,08, max_leaf_nodes=15, l2_regularization=1,0 y early_stopping=False. Se selecciona modelo más umbral antes de consultar TEST en esta ejecución.
RF optimizado a 0,30
0,8933
AUC; Precision 71,8 %; Recall 77,8 %; F1 74,6 %; señaladas 39,7 %.
HGB inicial a 0,30
0,9018
AUC; Precision 76,2 %; Recall 75,3 %; F1 75,7 %; señaladas 36,2 %.
Se estudian nueve umbrales entre 0,20 y 0,60 en VALIDATION. El umbral convierte una probabilidad en una decisión: con 0,30, una probabilidad de cancelación de 0,72 activa una alerta. Reducirlo suele aumentar Recall y volumen de intervención, pero reducir Precision.
HGB a 0,25: Precision 72,5 %, Recall 80,0 %, F1 76,1 % y 40,5 % señaladas. A 0,30: Precision 76,2 %, Recall 75,3 %, F1 75,7 % y 36,2 % señaladas. Se prioriza reducir falsas alarmas y carga con una pérdida pequeña de F1. Sin costes reales de FP/FN no se demuestra un óptimo económico.
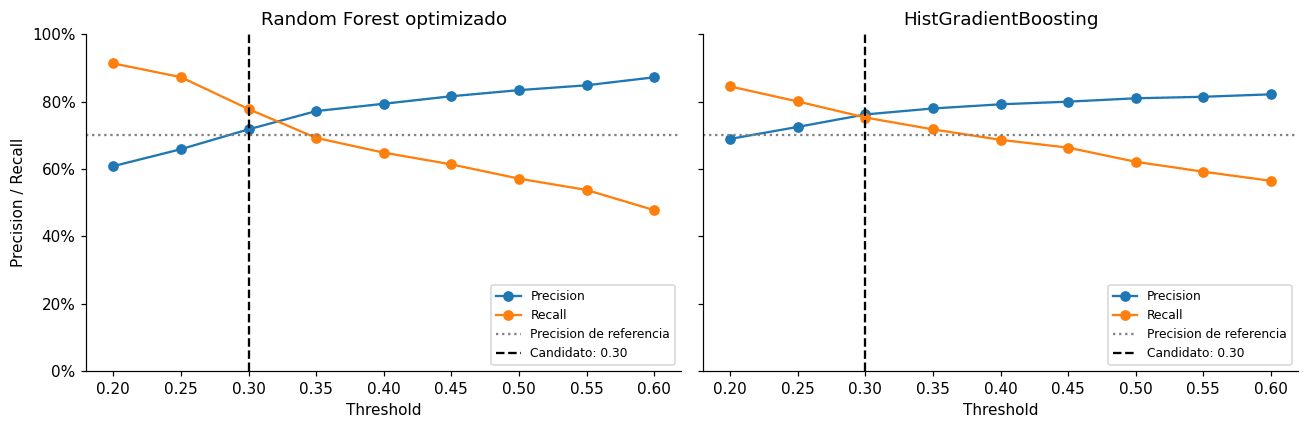
Curvas originales de VALIDATION, celda 53 del notebook.
8.014 verdaderos positivos, 987 falsos negativos, 3.731 falsos positivos y 9.466 verdaderos negativos. No se mantiene la referencia provisional del 70 % de Precision. Estos resultados no acreditan un ahorro económico ni un despliegue en producción.
ROC-AUC
0,8914
Discriminación en el periodo final.
Precision
68,2 %
Aproximadamente 68 de cada 100 alertas cancelan.
Recall
89,0 %
Aproximadamente 89 de cada 100 cancelaciones detectadas.
F1
77,3 %
Equilibrio entre Precision y Recall.
Reservas señaladas
52,9 %
11.745 de las 22.198 reservas de TEST.
Falsas alarmas
31,8 %
De las alertas emitidas, no de todas las reservas.
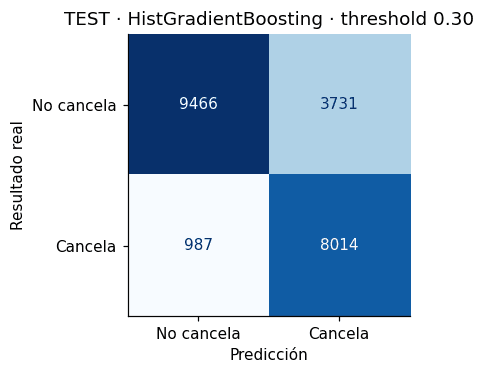
Evaluación guardada en la celda 59. Filas: resultado real; columnas: predicción.
TEST pertenece a un periodo posterior y el modelo final se reentrena con desarrollo completo. El cambio es compatible con diferencias de distribución, pero no demuestra por sí solo su causa. No se reajusta el umbral tras observar TEST: hacerlo contaminaría la evaluación.
SHAP explica cómo cada variable aumenta o reduce la puntuación del modelo, no una relación causal. Se utiliza TreeExplainer sobre el HGB final y una muestra aleatoria de 250 reservas de TEST, sin elegirlas por su etiqueta.
Ranking agrupado por variable original: country, agent, required_car_parking_spaces, total_of_special_requests, lead_time, customer_type, market_segment y arrival_date_year. El gráfico muestra columnas individuales, incluidas las categorías One-Hot.
Los aportes se expresan en log-odds, no en puntos porcentuales. Se comprueba que valor base más contribuciones, convertido a probabilidad, reproduce predict_proba.
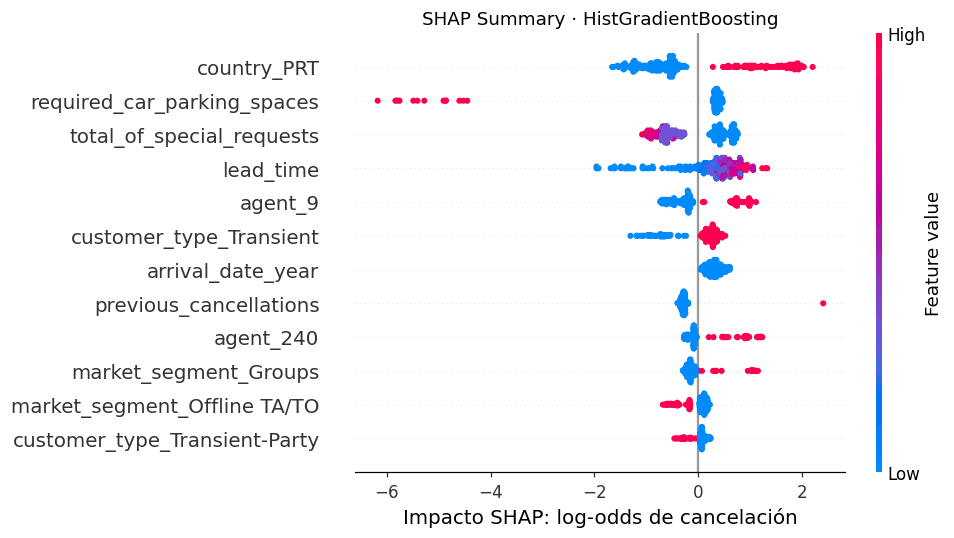
Gráfico original de la celda 61. El ranking depende del modelo y de la muestra.
En el caso de mayor riesgo estimado, country=PRT, market_segment=Groups y lead_time=323 días aumentan la puntuación. El waterfall suma aportes positivos y negativos al valor base. Es un caso extremo seleccionado por la predicción, no una reserva representativa ni una regla causal.
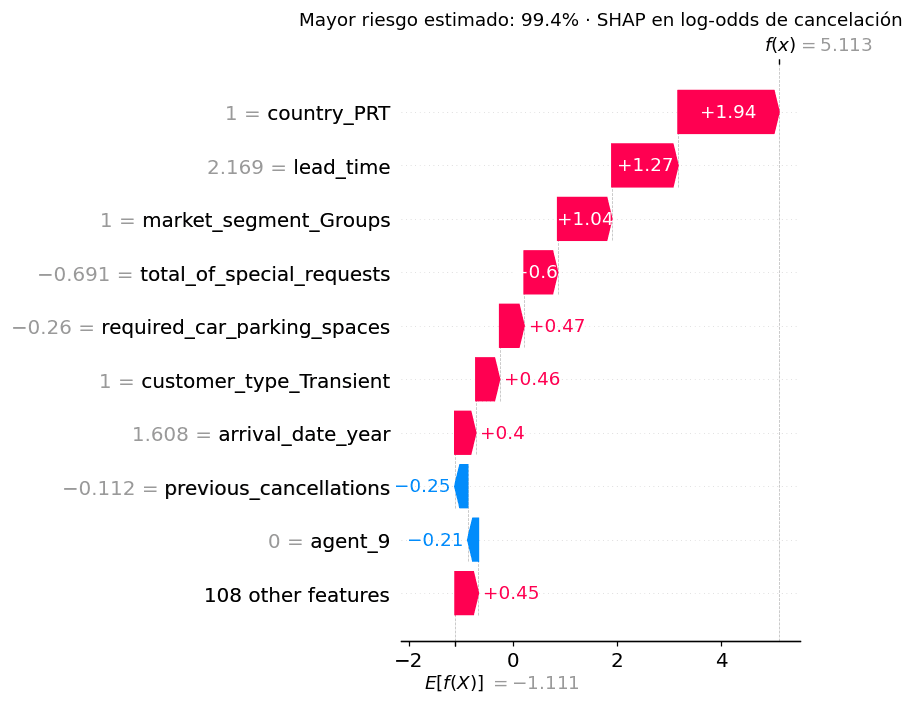
Primer waterfall de la celda 63; escala log-odds.
Solicitar parking aparece asociado con menor riesgo estimado; no significa que el parking evite cancelaciones. En el ejemplo de menor riesgo su aporte es negativo. Antes de producción se necesita verificar la solicitud inicial, comparar estabilidad entre periodos y evaluar modelos con y sin parking.
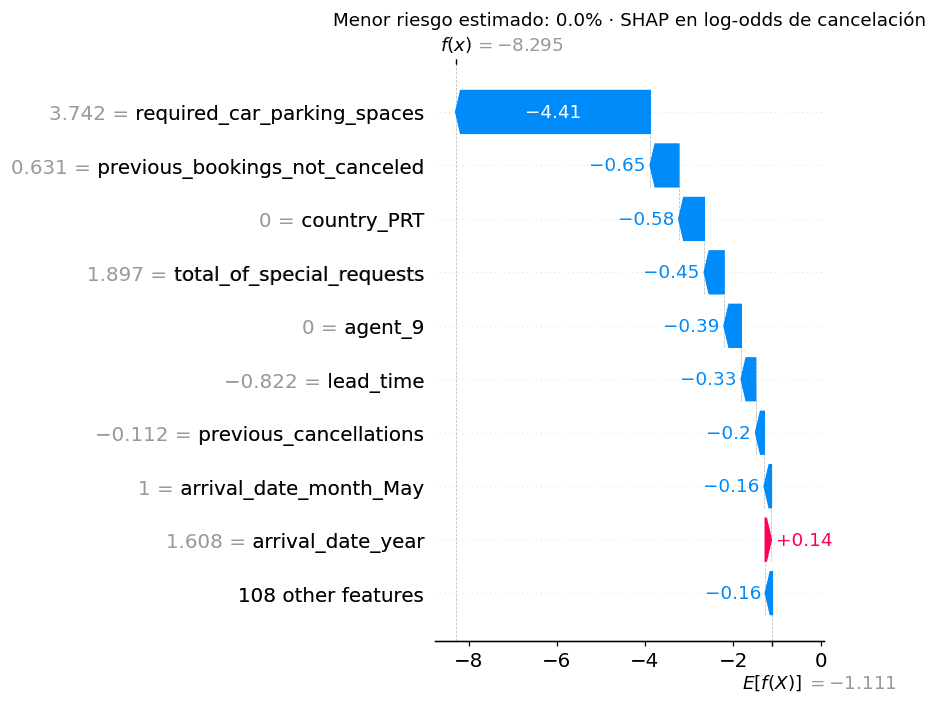
Segundo waterfall de la celda 63; ejemplo individual, no prueba causal.
La propuesta es un piloto supervisado, no una política automatizada ya validada. Los niveles siguientes son conceptuales: no se han validado umbrales adicionales para tres bandas de riesgo.
Un falso negativo puede perder la oportunidad de revender una habitación; un falso positivo añade una intervención innecesaria. Estimar ambos costes permitiría elegir un umbral según coste esperado y capacidad real del equipo, en datos de validación nuevos.
Documentación, notebooks, entregables y archivos organizados como dossier consultable.
Código fuente y notebooks del proyecto.
Análisis completo con salidas guardadas, selección de modelo y SHAP.
Presentación original de 14 diapositivas en PDF.
CSV original: 119.390 reservas y 32 columnas (17 MB).
Fuente principal: cancelaciones_hoteleras_DanielGarcia.ipynb, con salidas guardadas. El dossier prioriza el notebook y el CSV frente a erratas de la presentación. Las figuras conservan los rótulos originales en español.